一个新的整车 CAD 数据包到达 CFD 部门。真正花时间的往往不是求解,而是求解之前的一大段工作:几何检查、几何修复、PID / 零件组织、去特征、表面准备、包面,再到面网格和体网格。一个 case 里最重的部分,是这些步骤中反复出现的工程判断。
工程师每次面对一个新车型,都要回答同一类问题:哪些零件要保留,哪些可以删除,哪些小孔可以填,哪些 gap 不能填,哪些 surface defect 必须修,哪些可以交给 wrapper,哪些零件需要独立 PID,哪些区域需要特殊的 mesh treatment,以及——这个 CAD 修改到底会不会改变最终的空气动力学结果。
工具本身是确定的。ANSA、STAR-CCM+、ANSA scripting、batch automation,都是成熟的东西。真正没有被解决的是这些判断,而不是点击本身。
01症结不在求解算力,而在前置工程判断
一条标准的乘用车外流场 CFD 交付链大致是这样:
OEM CAD → 几何清洗与拓扑修复 → PID / 零件语义编排 → 特征简化 → 表面包面与重构 → 空间网格划分 → 求解器计算
后半截——体网格生成与多核并行求解——早就高度工程化了。前置的三道关卡却常年靠人工经验撑着。
几何连通性与缺陷容忍度。 成百上千处干涉面、微小缝隙、非流形边里,哪些会让网格生成器直接崩掉,哪些对阻力流场完全透明?这个问题没有通用答案,它取决于车型、取决于工况,也取决于这一次算的到底是什么。
CAD 元数据与流体物理的角色错配。 设计部门交付的数模里,零件名往往只有一个生硬的代号,比如 Part_88412_RevC。求解器不知道这个零件在流场里扮演什么角色。工程师得亲手判断:它属于高速旋转的轮辋、平整化底护板,还是机舱内部阻碍热回流的挡风板。
几何简化对气动特性的连锁反噬。 抹平一个圆角,究竟是卸掉了不必要的网格负担,还是人为诱发了一场原本不存在的大面积边界层分离。
这三件事背后其实是同一个问题,它比「怎么让 AI 替人去点按钮」要实际得多:
Can we reduce the amount of engineering judgment that has to be repeated manually every time a new vehicle arrives?
每一批新车到达时,工程师被迫重复调动的那部分经验决策,能不能沉淀成一条机器可审计的受控决策链。
02先做确定性规则,再去碰不确定的模型
从零搭这套系统,第一步不该落在模型上。顺序是先 Automation,再 AI。
原因不复杂。一个工程师一天 8 小时花在前处理上,时间大致切成这么几块:
- 3 h 高频机械劳动:格式转换、标准命名、几何 QA、固定目录打包
- 2 h 用工具排查明显的重叠面、相交面和破孔
- 1 h 核对零件清单,手工给数模部件分配 PID
- 1 h 针对复杂流道和分离区边缘做真正的工程决策
- 1 h 处理软件崩溃、模型拓扑异常这类突发意外
如果一上来就去训模型、让大模型生成几何脚本,模型带来的不可解释性和随机错误,会逼着工程师花更多时间去逐条核对——最后可能比原来还慢。
Automate what is deterministic before learning what is uncertain.
先把能写成规则、确定会发生的事自动化,再去学习那些不确定的判断。
第一层完全不需要 AI。几何 QA(free edges、duplicate surfaces、intersecting surfaces、small faces、short edges、non-manifold entities、gaps、overlaps、invalid topology)、标准操作(delete、merge、stitch、fill、project、move、repair、rename、PID assignment)、批处理(import、check、repair、export)——这些全部通过 ANSA scripting 完成。
把那 3 小时机械劳动和几何 QA 变成全自动批处理,单车前处理工时能从 8 小时压到 5 小时:
8 h → 5 h
这部分收益是确定的,没有误判风险,也不需要任何机器学习模型参与。
03ANSA 是最好的执行引擎,别去重造轮子
企业已经在用 ANSA,为了引入 AI 把它换掉没有道理。ANSA 承担 CAD interpretation、geometry editing、topology、mesh preparation 和 quality checking,底层的拓扑缝合、曲面投射、非结构面网格生成器与包面算法,是几十年全球车企真实工况捶出来的东西。
值得警惕的是另一种做法:让模型绕开这些成熟内核,自己写一套简易的几何度量算法去直接改 CAD。这条路的终点通常是网格生成全面崩溃。
反模式   LLM / 神经网络 → 自研几何算法 → 未校验的破损曲面 → 网格崩溃

分层     AI 决策层 → Action Schema → ANSA Python API → 原生几何内核
所以系统的形态是 AI 在 ANSA 之上加一层决策,而不是在底下重写一套几何内核。软件层只作为无状态的执行插件存在,核心不与任何具体软件的专有代码硬编码纠缠。
04架构核心:构建 CFD 领域工程语义层
AI 真正具备介入价值的起点,是消掉 CAD 结构数据和流体力学物理语义之间的那道鸿沟。
设计部门交上来的几何树里可能只有一个冷冰冰的代号。但流体工程师在分配网格参数时,必须知道它在空间流场里的物理定位。所以中间需要一个显式的工程语义转换层:
[ CAD 原始数模 ]
零件代号: Part_88412_RevC / 材质: PA66 / 装配位置: Front Axle Lower
       ↓ 规则映射 + 文本元数据分类器
[ 领域工程语义 ]
分类: 悬架连杆保护罩 / 属性: 非耐压薄壁结构
       ↓ 注入 CFD 工况边界
[ CFD 求解角色 ]
角色: UNDERBODY_ROUGHNESS / 网格策略: 允许包面合并
边界条件: 绝热无滑移壁面
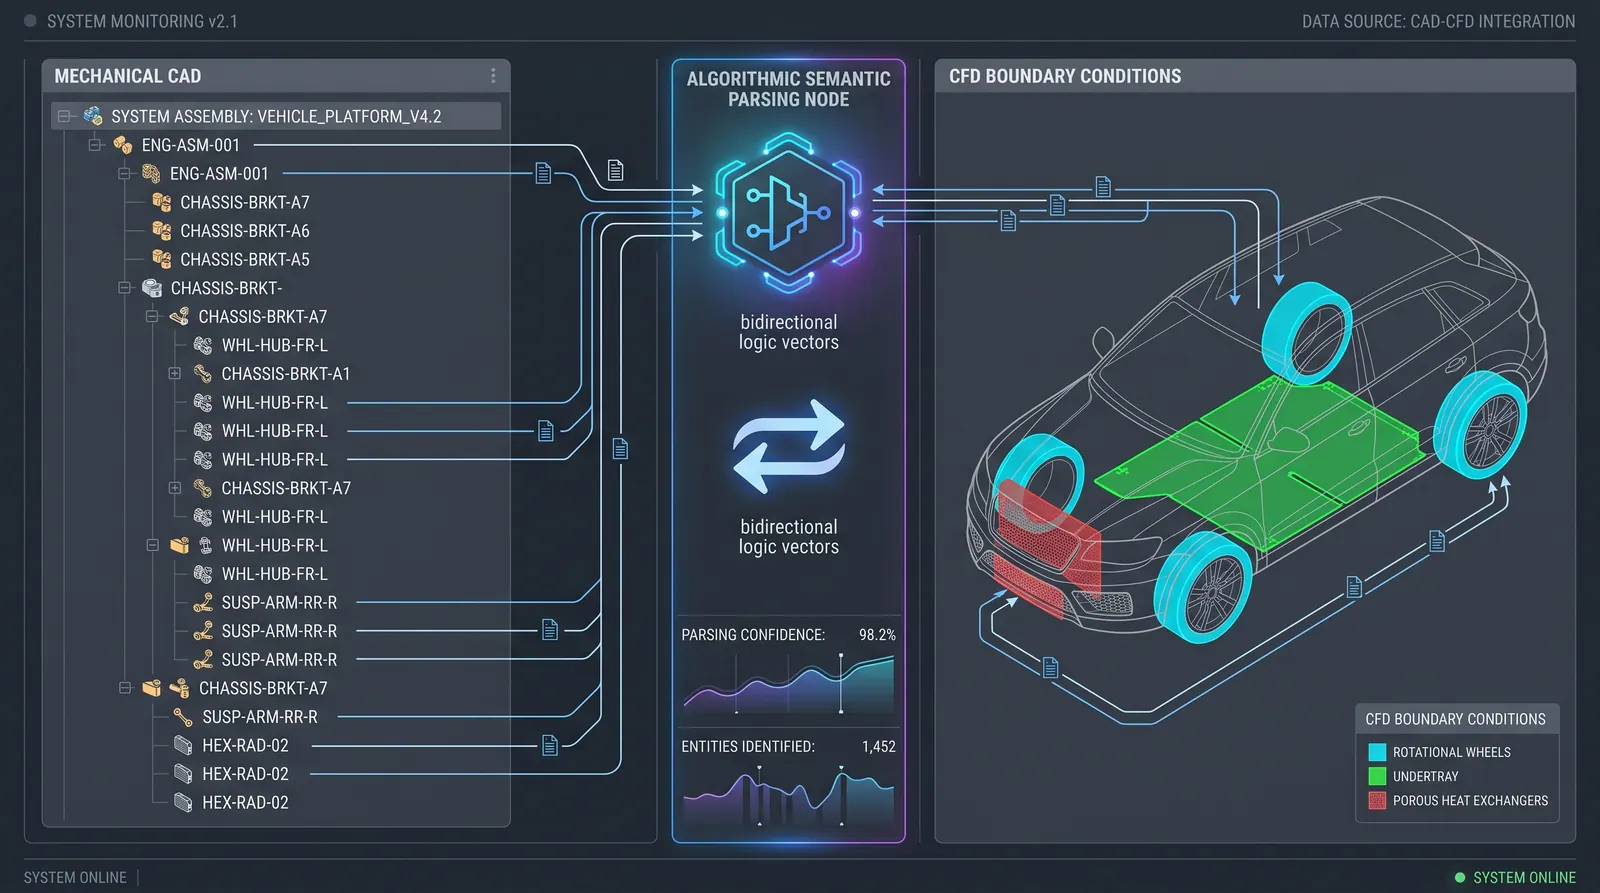
PID 不只是名字,它是流体边界的元数据容器
在传统流程里,PID 往往被当成模型树上的一个标签。但在深度前处理架构里,PID 是整车物理边界条件的元数据载体。
一个组件一旦被精确赋予 COOLING_CORE 的语义,后端的流水线就会自动接管并触发一串确定性的连锁反应:在 ANSA 里它被自动跳过几何去特征;网格划分阶段强制施加多孔介质六面体加密;导出到 STAR-CCM+ 时自动挂载多孔介质惯性阻力与黏性阻力张量公式。
所以打通 BOM 元信息到 CFD 工程语义的这条识别映射,本身就是一件值得投入的事。它不是给零件改名,而是给后面整条流程铺语义基础。
05动作安全边界:Action Schema 与策略闸门
在任何严肃的工业前处理系统里,让 AI 直接生成无约束的 Python 脚本、在生产模型上静默运行,是不能接受的。AI 输出的必须是遵循严格 schema 校验的结构化操作意图:
{
  "case_id": "AERO_2026_E8_EXT",
  "target_entity": "SURF_HOLE_4412",
  "action_type": "DEFEATURE",
  "operation": "FILL_HOLE",
  "parameters": {
    "max_diameter_mm": 2.5,
    "curvature_continuity": "TANGENT"
  },
  // 内部隐藏支架的安装孔,对外部气动无影响
  "rationale": "Internal hidden bracket mounting hole, zero external aerodynamic impact",
  "confidence_score": 0.96,
  "risk_level": "LOW",
  "requires_human_review": false
}
策略校验器:执行前的护栏
这份 JSON 动作对象在提交给 ANSA 适配器之前,必须过一遍硬编码的策略校验器:
AI 提出动作意图 (Action Schema)
         │
         ▼
硬性规则拦截门禁
├── 1. 目标实体是否存在,且未被上游锁定?
├── 2. 该动作是否触碰被保护的气动敏感面?
├── 3. 当前分析工况是否允许该特征简化?
└── 4. 综合工程风险是否击穿自动执行阈值?
         │
         ├── [不合规 / 高风险] ──> 强制转交人工审查队列
         └── [校验通过] ─────────> 派发给 ANSA Adapter 执行
同一条「删除小孔」的指令,因为所处的位置和工况不同,拦截结论可以完全相反:
- 平整电池包底护板上的 2 mm 紧固孔 → 安全通过,全自动填平
- 主动进气格栅导流片迎风边缘的 2 mm 模具工艺孔 → 拦截封锁,必须人工复核
AI 输出的是动作意图,不是可执行代码。它从头到尾不拥有直接修改几何的权限——权限在策略层手里。
06几何风险分诊
一辆车有五万个独立曲面,要求工程师逐个排查所有警告并不现实。传统几何度量报告经常一次报出几千条缺陷,结果是工程师告警疲劳,全部点跳过。
模型在这里有一个很合适的落脚点:当几何风险分诊系统。它不需要拥有自动修复几何的能力,只需要对每一个可疑特征——狭窄缝隙、局部大曲率交叠、锐角面相交、短边自由边界——做多维相关性评估,结合工况给出一个网格破损与流场失真的风险分数:
几何 QA 扫描得到 3,200 处瑕疵
         │ 按空间拓扑与流场上下文排序
         ▼
Rank 01  侧气帘出口与轮罩搭接处局部穿透 (0.98) ──> 人工紧急介入
Rank 02  后扩散器下边缘 0.5 mm 间隙撕裂 (0.95) ──> 人工紧急介入
...
Rank 20  尾灯内部反射面狭小缝隙 (0.12) ──> 可交给 Wrapper 闭合
这样系统把堆积如山的缺陷收敛成最致命的二十个。模型只做排序和提示,不碰执行——这件事的风险比让它改几何小得多,而工程价值已经出现。
07气动语境下的特征简化
传统的 CAD 简化通常是纯几何视角的:设一个距离阈值,把小于 3 mm 的圆角全裁掉、倒角全切平。这套机械做法在空气动力学里经常出问题。
一个能用的前处理决策系统必须带流体力学上下文。它的决策函数吃的是物理与装配维度的复合张量:
一次 external aero 计算的上下文可以写成:
analysis: external_aero · velocity: 120 km/h · yaw: 0° · ground: moving · wheels: rotating (MRF) · cooling: simplified
在同一个上下文里,两个尺寸完全相同的特征会得到相反的处理:
- 前轮前方导流板下边缘的 1.5 mm 翻边 → KEEP。处在高剪切分离边缘,简化会改变下车体的入流冲角。
- 乘员舱下方副车架内腔的 1.5 mm 钣金工艺翻边 → REMOVE。处在深腔死水区,对整车宏观流动阻力没有贡献。
没有显式的工况上下文输入,只凭三维尺寸来决定特征取舍,在气动上是不成立的。
08生产级落地骨架:解耦的系统工程架构
搭工程平台首先要放弃零散临时脚本的思路。一个能长期运行、可多项目复用的编排平台,分层大致是这样:
工程师交互界面 (Web UI / Review GUI)
  缺陷分诊看板 · 动作批量审批 · 差异化 Diff 确认
              │ gRPC / WebSocket
              ▼
系统编排引擎核心 (Rust Orchestration Layer)
  Case 调度 · 状态机 · 数据追溯链 · 策略校验器
     ┌────────────┼────────────┐
     ▼            ▼            ▼
确定性规则库   ML 决策服务   LLM 语义解析
     └────────────┼────────────┘
                  ▼
统一动作抽象层 (Action Schema & Policy)
        ┌─────────┴─────────┐
        ▼                   ▼
ANSA 适配器 (Python)   STAR-CCM+ 适配器 (Java)
为什么编排层选 Rust
如果只是写几行调用 ANSA 的临时脚本,Python 足够快。但当它变成一个覆盖海量数模、跨节点分发算力、要跟踪历史变更痕迹的长期平台时,稳定性要求就变了。
Rust 在这里承担骨架的理由有三条。状态机在编译期锁死类型,Import → Triage → Review → Execute → Mesh 之间的非法跳转漏不到运行时;并发分发数模切片和调度几何分析算力时内存开销低,不需要额外堆一套容器集群;Action Schema 通过类型系统固化,异常浮点数和破坏性指令进不了执行层。
厂商的专用生态各自守在适配层两端——ANSA 的二次开发交回 Python,STAR-CCM+ 的流程控制继续用 Java 原生宏。核心调度与底层工具解耦之后,将来即使把几何工具换成别的软件,整套系统资产依然能复用。
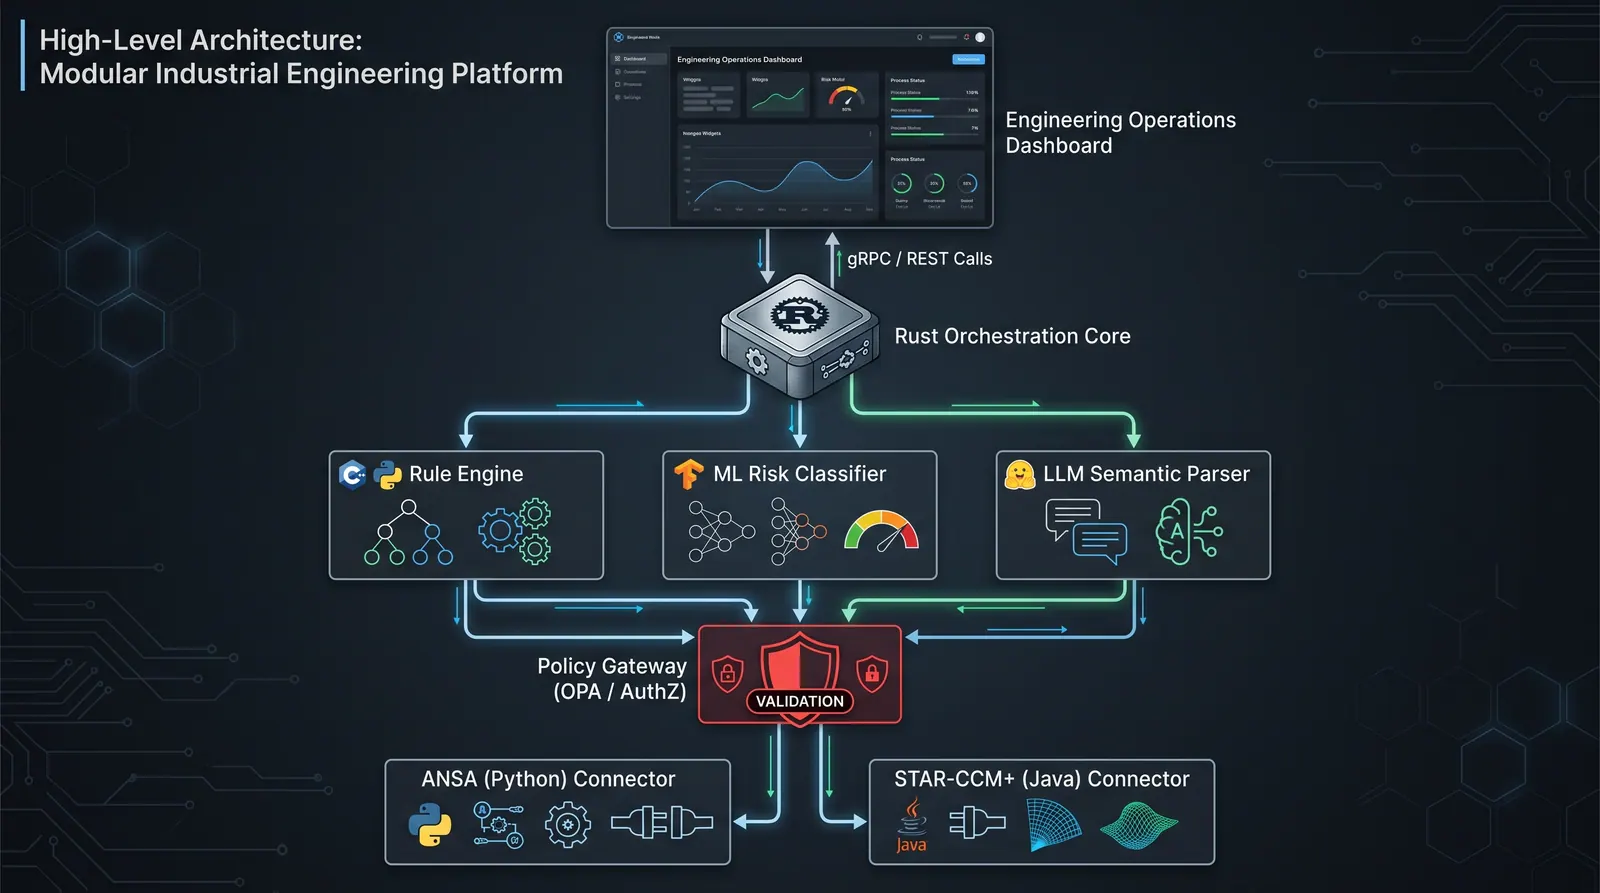
09存储选型
工程落地容易走偏的一步,是赶时髦把所有数据都倒进向量数据库。数据该进哪种存储,由它的访问模式决定:
| 数据类型 | 典型样本 | 匹配存储 | 架构原由 |
|---|---|---|---|
| 结构化拓扑与任务状态 | 车型、版本批次、零件 ID、几何属性、审批人、最终阻力系数 | 关系型数据库 (PostgreSQL / SQLite) | 强事务支持,外键约束与历史审计链路可回溯 |
| 几何点云与局部特征描述 | 破损曲面坐标切片、三维网格质量统计直方图 | 对象存储 (MinIO / S3) 或二进制紧凑 Blob | 数据体量极大,不该占用数据库索引与内存页缓存 |
| 非结构化工艺知识库 | 专家排障记录、企业前处理 SOP 规范、历史案例排查报告 | 向量数据库 (LanceDB / Qdrant) | 支撑大模型的低频语义检索与相似案例推演 |
每一项决策,都必须留下可追溯的工程因果
模型不能只凭统计概率去偷偷改几何。系统里生成的每一条操作记录,都要带完整的工程上下文凭证:
-- 典型的决策追踪审计记录
INSERT INTO preprocessing_decisions (
    case_id, part_id, action_taken, failure_mode,
    cfd_context, engineer_id, approval_status, execution_timestamp
) VALUES (
    'CASE_2026_SUV_AERO', 'PART_BRACKET_UNDERBODY_01', 'FILL_HOLE',
    'INTERNAL_BLIND_CAVITY', 'EXTERNAL_HIGH_SPEED_120', 'ENG_WAYNE_07',
    'AUTO_APPROVED_BY_POLICY', NOW()
);
这套数据体系在主机厂运行半年、沉淀出上百个车型的全链路记录之后,后续机器学习面对的就再也不是脱离工业背景的公开模型,而是一座属于这家企业自己的高保真标注资产。
10物理验证是最后的闸门
模型吹嘘的准确率在工业上没有意义。整套前处理流程合不合格,得由流场的收敛精度与物理量来裁决。
在准入验证阶段,把未经验证的基准原始方案和 AI 受控预处理方案背靠背送进求解器做盲测:
对关键机舱进气区域,还要严格复核换热器端面的质量流量偏差:
判据里的三个容差——阻力系数的 、升力系数的 与冷却质量流量的 ——按具体项目的目标设定,量级通常在 这一段。
验收本身分三级,每一层都过,这套前处理产出才允许签署发布:
Level A · 几何有效性
  无破面 · 无悬空非流形 · 无穿透
  ↓ 通过
Level B · 网格物理质量
  扭斜度 (skewness) · 边界层 y+ · 增长率 · 非正交性
  ↓ 通过
Level C · 流场关键物理量
  ΔCd · ΔCl · 局部截面压力分布 · 冷却流量
几何完好、网格健康、气动指标落在公差带内,这套流程才算闭合。
11现实演进路径:五个渐进推进阶段
没有哪家车企能承受把未经验证的技术直接推上量产流程的代价。整套系统的铺开只能是渐进的:
- Phase 0 · Observe —— 不介入生产流,只在后台静默记录工程师面对几何瑕疵的实际操作,沉淀原始决策样本。
- Phase 1 · Automate —— 把几何拓扑检查、标准部件重命名、固定组件 PID 分配彻底脚本化。前处理工时立刻降一档。
- Phase 2 · Assist —— 分诊模型上线,对上千处缺陷做优先级排序并给出操作建议,但由人工点击确认。
- Phase 3 · Controlled Automation —— 策略网关通电。验证过的低风险动作(内部盲孔填平、重复面移除)走自动审批闭环,高风险区强制保留人工签署。
- Phase 4 · Closed Loop —— 打通与求解器输出的数据总线,把每一次物理计算的对齐结果回流给决策层。
每一阶段都建立在上一阶段攒下的数据与信任之上。
12工业落地的成功标尺
这套系统成不成,不看模型参数量有多大,也不看演示视频有多科幻。看的是三个能算出来的东西。
人均交付周期的缩短。 全车前处理基准工时从 100 小时/台,经过确定性自动化降到 55 小时/台,AI 辅助之后到 45 小时/台。
人工干预比例的下降。 需要工程师握着鼠标逐点微调的几何实体比例,从整车的 100% 降到 35%,再降到 15%。
100 → 55 → 45 hours/case · 100% → 35% → 15%
技术资产的沉淀。 资深专家轮岗或离职之后,沉淀在策略层与决策库里的工程边界规则还在,新项目的前处理交付底线不会跟着人走。
成功不是「AI 自动处理了整辆车」。是工程师的工作方式变了:以前是找问题 → 理解 → 决定 → 编辑 → 检查,问题散落在几万个几何实体里,光找出值得决定的问题就要花掉大量时间;接入系统之后变成 AI 找、排序、给建议,工程师审核、批准,再由既有链路执行。
工程师仍然做决定,只是不再花大量时间去寻找那些值得决定的问题。寻找的工作被系统接管了,决定本身仍然属于人。
这篇 Field Note 是工程实践视角的系统设计笔记,与承担「文献证据」角色的研究综述分开:这里不引入论文引用链,而是讨论如果今天真的要把 AI 放进一个汽车 CFD 部门,系统应该怎么分层、先做什么、哪些先不做、怎么验证。
需要保持的事实边界:目前没有清晰、可独立验证的公开案例,证明某个 AI 系统能在生产环境里自主完成「OEM CAD → ANSA 级几何 → PID / BOM 语义映射 → defeaturing → wrapping → 生产级 CFD」的完整闭环。厂商报告的效率收益属于厂商宣称,不是独立证据;研究原型(例如把 LLM 用于前处理脚本或几何操作的研究)也还没有达到汽车级 CAD 前处理决策自动化的程度。
文中 8 h → 5 h、100 → 55 → 45 hours / case、100% → 35% → 15% 这组数字用于说明系统形态与量级,不代表任何一家厂商的实测数据。分诊队列里的风险分数与缺陷计数、Action Schema 与审计记录里的字段值,同样是为说明结构而写的示例。两张配图是 AI 生成的示意图,画面里的读数、编号与零件清单也是生成产物,正文不引用其中任何数字。文中对 ANSA、STAR-CCM+、Wrapper 等工具与方法的描述,仅说明通用工程架构,不构成对任一软件具体能力的承诺。